
Vielleicht liegt so ein Angebot gerade auf Ihrem Tisch: FAQ-Schema nachrüsten, Tabellen einbauen, die Inhalte „für die KI strukturieren“, damit ChatGPT Sie als Quelle nennt. Wir haben nachgemessen, an 101 Herstellerseiten, die die KI in 30 Tagen alle gelesen hat. 50 davon nennt sie fast immer, 51 fast nie. Keines von 21 Strukturmerkmalen erklärt den Unterschied. Was ihn erklärt, steht weiter unten, und es ist eine gute Nachricht für alle, die ihr Budget lieber in Seiten als in Markup stecken.
Zwei Wörter vorweg. Gelesen heißt: Die KI holt eine Seite, um daraus ihre Antwort zu bauen. In der Studie heißt das Abruf. Genannt heißt: Sie zeigt die Seite in der Antwort als Quelle an. Das sind zwei getrennte Schritte, und dieser Beitrag handelt vom zweiten.
101 Herstellerseiten im Vergleich: 50 fast immer genannt, 51 fast nie
Aus dem Panel haben wir Herstellerseiten mit mindestens 25 Abrufen ausgewählt und in zwei Gruppen geteilt: Seiten, die bei mindestens 90 Prozent ihrer Abrufe auch genannt werden, und Seiten, die bei höchstens 45 Prozent genannt werden. Beide Gruppen hat die KI nachweislich gelesen. Der Unterschied liegt ausschließlich in der Nennung.
Dann haben wir die Seiten selbst geholt, als vollständiges HTML, und 21 Merkmale gemessen: Wortzahl, Überschriften, Listen, Tabellen, Links, Bilder, Schema-Auszeichnungen, Autor, Datum, Satzlänge, Frageform.
Die selten genannten Seiten haben sogar öfter FAQ-Schema und Datum
| Merkmal | Genannt (Median) | Stumm (Median) |
|---|---|---|
| Wörter im Hauptinhalt | 1.332 | 1.365 |
| Überschriften | 18 | 23 |
| H2 | 8 | 9 |
| Listen | 21 | 17 |
| Tabellen | 0 | 0 |
| Externe Links | 16 | 41 |
| Bilder | 13 | 16 |
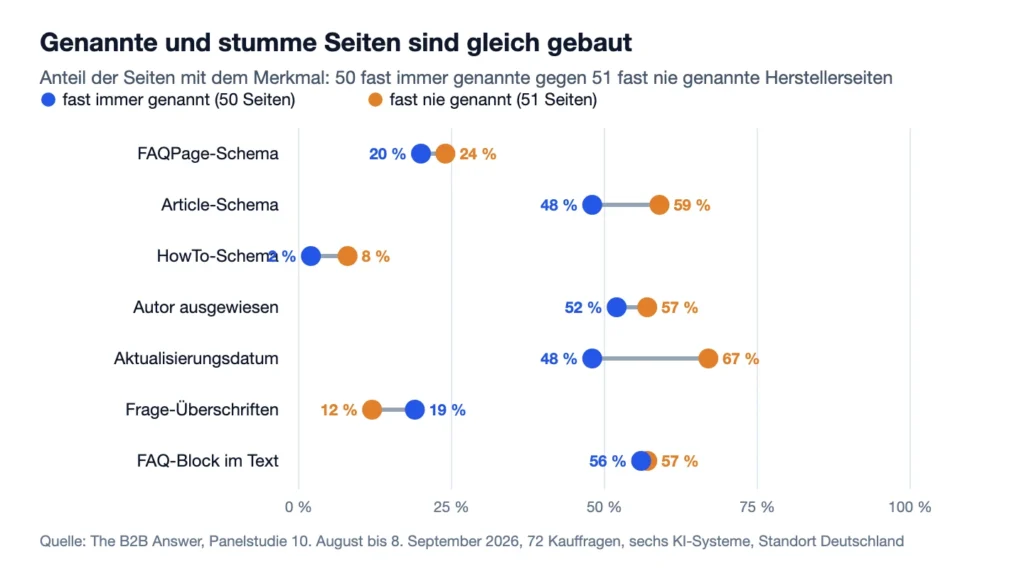
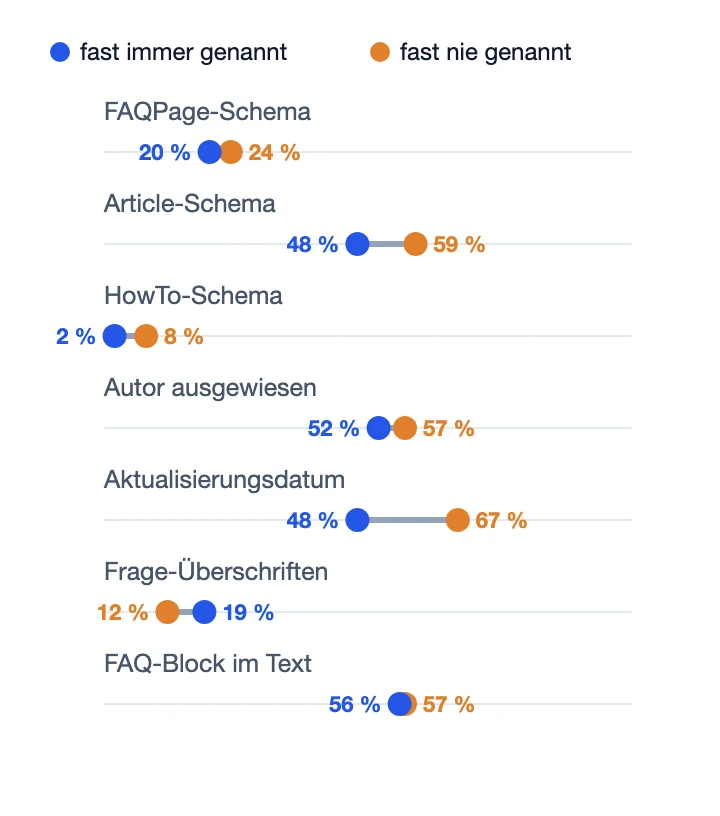
Bei den Auszeichnungen wird es deutlicher. FAQPage-Schema tragen 20 Prozent der genannten und 24 Prozent der stummen Seiten. Ein Aktualisierungsdatum haben 48 Prozent der genannten und 67 Prozent der stummen. Wenn überhaupt, sind die stummen Seiten besser ausgezeichnet.
Zahlen als Tabelle
| Merkmal | Fast immer genannt (50 Seiten) | Fast nie genannt (51 Seiten) |
|---|---|---|
| FAQPage-Schema | 20 % | 24 % |
| Article-Schema | 48 % | 59 % |
| HowTo-Schema | 2 % | 8 % |
| Autor ausgewiesen | 52 % | 57 % |
| Aktualisierungsdatum gesetzt | 48 % | 67 % |
| Frage-Überschriften | 19 % | 12 % |
| FAQ-Block im Text | 56 % | 57 % |
Kein einziges Merkmal macht einen messbaren Unterschied, und das Ergebnis ist eindeutig. Auch der Text selbst unterscheidet die Gruppen nicht. Satzlänge 15 gegen 16 Wörter, Absatzlänge 25 gegen 25, FAQ-Block im Text 56 gegen 57 Prozent.
Das KI-System entscheidet: ChatGPT nennt wenig, Copilot fast alles
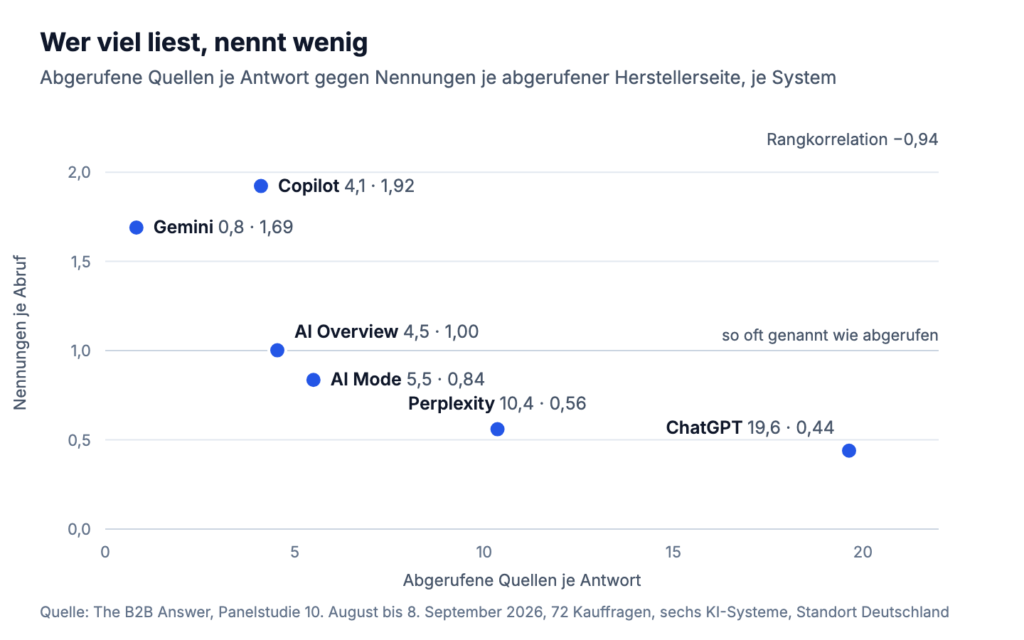
Was die Gruppen trennt, ist das KI-System, das antwortet.
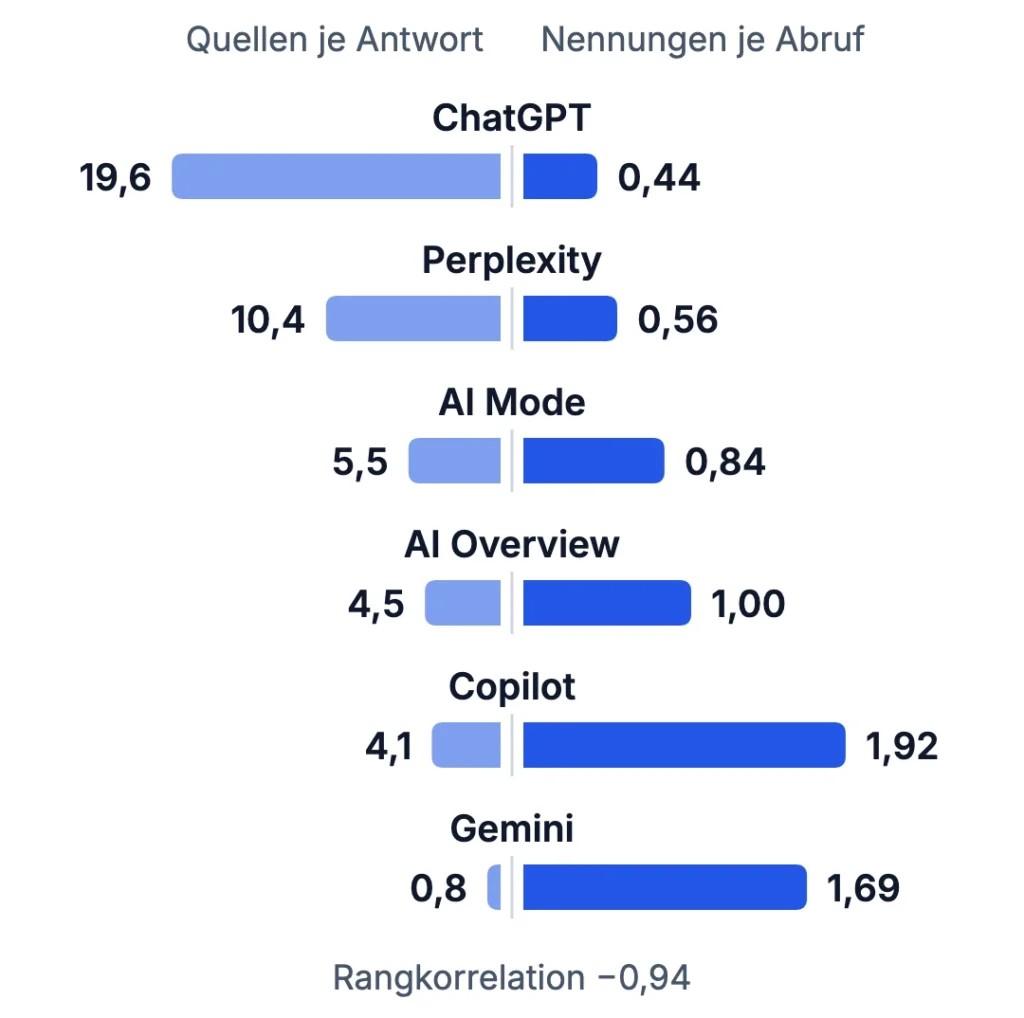
Zahlen als Tabelle
| KI-System | Quellen je Antwort | Nennungen je gelesener Seite |
|---|---|---|
| ChatGPT | 19,6 | 0,44 |
| Perplexity | 10,4 | 0,56 |
| Google AI Mode | 5,5 | 0,84 |
| Google AI Overview | 4,5 | 1,00 |
| Copilot | 4,1 | 1,92 |
| Gemini | 0,8 | 1,69 |
Je mehr Quellen ein System liest, desto kleineren Anteil davon nennt es. ChatGPT liest fast zwanzig Seiten je Antwort und nennt weniger als die Hälfte von dem, was es von Ihnen gelesen hat. Copilot liest vier und nennt fast jede davon doppelt. Zwischen den beiden liegt Faktor 4,4. Zwischen den vier Kaufphasen liegt Faktor 1,15. Zwischen den Seitenmerkmalen messen wir keinen Unterschied.
Ob Ihre Seite genannt wird, ist zum ganz überwiegenden Teil eine Eigenschaft des KI-Systems, das gerade antwortet. Dieselbe Seite, dieselbe Frage, zwei Systeme: einmal Quelle, einmal stumm.
Gute Gliederung hilft, damit die KI Ihre Seite überhaupt liest
Das Ergebnis gilt für die Frage, ob die KI eine Seite als Quelle nennt. Für die Frage davor, ob sie die Seite überhaupt liest, hilft Struktur sehr wohl. Wir haben 198 Seiten, die die KI in 30 Tagen nie gelesen hat, mit gelesenen Seiten derselben Websites verglichen. Die gelesenen Seiten tragen häufiger eine Article-Auszeichnung (64 gegen 36 Prozent), nennen häufiger einen Autor (63 gegen 39 Prozent), sind länger und stärker gegliedert, und sie behandeln öfter Kosten und Preise (42 gegen 10 Prozent).
Das bleibt als Empfehlung übrig: Überschriften als Fragen, genug Länge, klare Gliederung und ein Autorenname helfen, dass die KI Ihre Seite liest. Was sie danach als Quelle nennt, entscheidet das jeweilige System.
Viele Angebote versprechen, dass die KI Sie als Quelle nennt, und liefern Maßnahmen, die dafür sorgen, dass sie Sie liest. Das zweite ist sinnvoll. Für das erste finden wir in unseren Daten keinen Beleg.
Beispiel: Die Leistungsseite schlägt die FAQ-Seite desselben Herstellers
Die FAQ-Seite eines Embedded-Herstellers im Panel trägt FAQPage-Schema und zwölf Frage-Überschriften, also alles, was das Angebot auf Ihrem Tisch verspricht: 6 Abrufe, 1 Nennung in 30 Tagen. Die Leistungsseite desselben Herstellers, ohne FAQ-Schema, mit Überschriften wie „Standard Produkt vs. kundenspezifische Lösung“ und „Garantierte Langzeitverfügbarkeit“: 18 Abrufe, 10 Nennungen. Den Unterschied macht die Frage. Die zweite Seite beantwortet etwas, das ein Käufer vor dem Kauf wissen will.
Ihr Budget bringt mehr in Seiten, die Fragen Ihrer Käufer beantworten
Wenn Ihnen jemand FAQ-Schema und Tabellen verkauft, damit die KI Sie nennt, fragen Sie nach dem Beleg. In unseren Daten gibt es keinen.
Was Sie tun können, sorgt dafür, dass die KI Ihre Seiten liest: mehr Seiten, die Käuferfragen beantworten, mit Überschriften als Fragen, genug Länge, klarer Gliederung und einem Namen darunter. Welcher Seitentyp in welcher Kaufphase gelesen wird, steht in B2B-Content für jede Kaufphase. Wie oft Sie danach genannt werden, hängt vom jeweiligen System ab.
In Aufwand gerechnet: Eine solche Seite kostet einen Nachmittag Fachwissen und einen Tag Redaktion. Wenn FAQ-Schema und Tabellen nur im Angebot stehen, weil sie „nicht schaden“, kosten sie Geld, das für diese Seiten fehlt. Was die einzelnen Bausteine bei uns kosten, steht offen in Was kostet Generative Engine Optimization?.
Das Ergebnis gilt für 101 Seiten aus sechs Industriebranchen
Struktur wirkt, und zwar beim Gelesenwerden: Gut gegliederte Seiten mit Autor werden häufiger abgerufen. Das Ergebnis stammt aus 101 Seiten in sechs Industriebranchen; andere Branchen haben wir nicht gemessen. Es schließt große Effekte aus, also genau die, die in Angeboten versprochen werden. Kleine Effekte kann eine Stichprobe dieser Größe übersehen.
Ein Vorbehalt zur Methode: Wir haben alle sechs Systeme zusammen ausgewertet. Otterly.ai berichtet aus einem eigenen Experiment (Dezember 2025 bis März 2026), dass Schema-Markup nur bei Google AI Overviews und AI Mode einen Effekt zeigt, bei den übrigen Systemen keinen. Das verfeinert unseren Befund: Ein Effekt, der nur auf zwei von sechs Kanälen wirkt, kann im Gesamtvergleich verschwinden. Prüfen können wir das derzeit nicht, weil AI Overview seit dem 24. August zu wenige Nennungen liefert. Otterly verkauft Sichtbarkeitsmessung; der Befund ist eine Anbieterstudie ohne offengelegte Stichprobe. Für ChatGPT, Perplexity, Copilot und Gemini zeigen alle uns bekannten Messungen dasselbe: Auszeichnung bewegt die Nennung nicht messbar.
Unterm Strich: Struktur hilft, damit die KI Ihre Seite liest
Gute Struktur sorgt dafür, dass die KI Ihre Seite liest. Ob sie Sie als Quelle nennt, entscheidet das System, und das lässt sich nicht kaufen.
Fragen zu FAQ-Schema und KI-Nennung
Bringt FAQ-Schema etwas für die Sichtbarkeit in ChatGPT?
In unserer Messung über 101 Herstellerseiten tragen genannte Seiten zu 20 Prozent FAQPage-Schema, stumme zu 24 Prozent. Für die Nennung messen wir keinen Effekt. Für den Abruf helfen Frage-Überschriften und Gliederung, unabhängig vom Schema.
Was entscheidet dann, ob die KI eine Seite als Quelle nennt?
Vor allem das System, das antwortet. ChatGPT liest im Schnitt 19,6 Quellen und nennt davon 0,44 je gelesener Herstellerseite, Copilot liest 4,1 und nennt 1,92. Dieser Unterschied ist Faktor 4,4; zwischen Seitenmerkmalen messen wir keinen.
Was ist der Unterschied zwischen gelesen und genannt?
Gelesen heißt: Die KI holt Ihre Seite, um daraus ihre Antwort zu bauen. Darüber entscheidet Ihre Seite, mit Thema, Länge, Gliederung und Autor. Genannt heißt: Die KI zeigt Ihre Seite in der Antwort als Quelle an. Darüber entscheidet überwiegend das System, das gerade antwortet.
Quellen & Einordnungzum Ausklappen
- Oliver Bock (2026): Welche Websites liest ChatGPT, wenn Ihre Kund:innen einen Anbieter suchen? Was 13.108 KI-Antworten zeigen. Panelstudie, 10. August bis 8. September 2026, The B2B Answer, München. Abschnitt 4 behandelt den Unterschied zwischen gelesen und genannt.
- Rohdaten der Studie als CSV, darin die 101 vermessenen Seiten mit allen 21 Merkmalen.
- Otterly.ai: GEO-Experimentindex, Stand August 2026. Anbieterstudie, Schema-Effekt nur bei Google AI Overviews und AI Mode.
- B2B-Content für jede Kaufphase, Beitrag zu den Seitentypen, die die KI liest.
Zahlen in diesem Beitrag: 101 selbst heruntergeladene Herstellerseiten aus dem Peec-Panel, Mann-Whitney je Merkmal, Benjamini-Hochberg über 21 Tests; kleinster p-Wert 0,107 bei einer Schwelle von 0,002. Vergleich gelesen gegen nie gelesen: 198 gegen 78 Seiten derselben 68 Websites. Systemquoten aus 52.044 Abrufen von Herstellerseiten, 10. August bis 8. September 2026.